遺伝子変異やPCR、プライマー設計について調べていると、よく出てくる言葉が「エクソン」と「イントロン」です。
仕事で初めて、エクソンやイントロン、さらには「翻訳がどこから始まるか」といったことを知っている前提で説明された私は、完全にフリーズしました。
そもそも、エクソンとイントロンって何?
DNAや遺伝子とは何が違うの?
今回は、そんな疑問を一つずつ整理しながら、NCBIで実際の遺伝子を見て、エクソンとイントロンの違いを初心者向けに確認していきます。
※この記事ではNCBIの実際の画面を使って説明しています。NCBIは一画面に表示される情報量が多いため、画像によっては文字が小さく見える場合があります。細かい部分は、必要に応じて画像を拡大してご覧ください。
まずはNCBIで実際の遺伝子を見てみよう
早速、NCBIで実際の遺伝子を検索して、エクソンとイントロンを見てみましょう。
今回見るのは、TP53という遺伝子です。
TP53には複数の転写産物がありますが、今回は NM_000546.6 を見ていきます。
https://www.ncbi.nlm.nih.gov/gdv/browser/nucleotide/?id=NM_000546.6
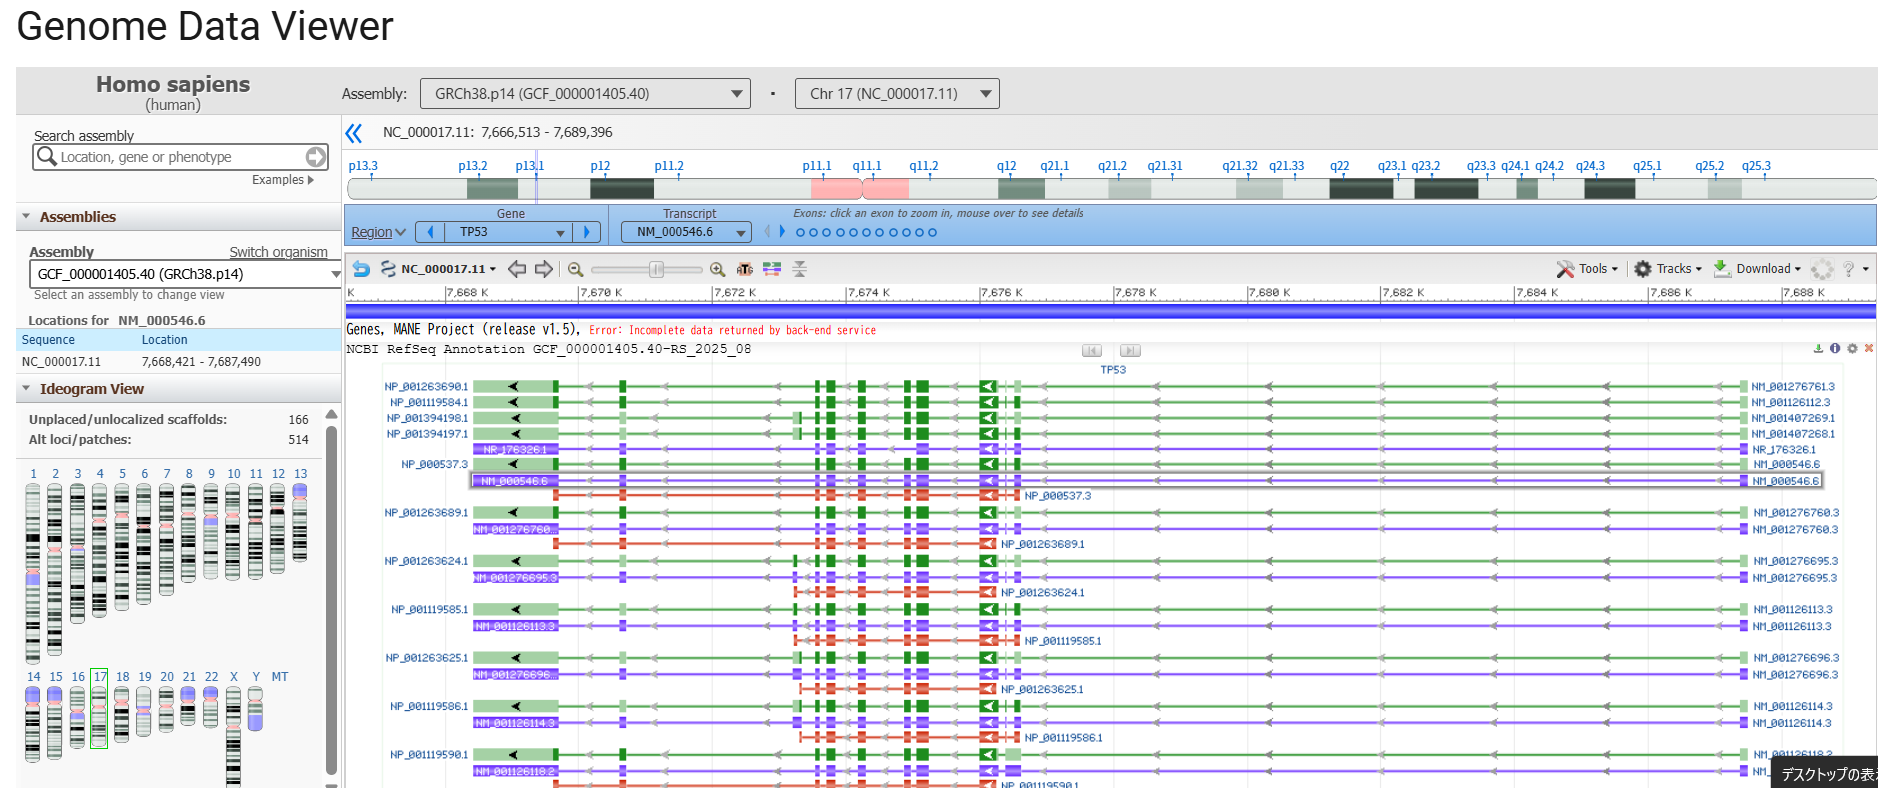
Genome Data ViewerでTP53を表示すると、少し小さくて見づらいですが、四角い箱と、それらをつなぐ線がずらっと並んでいます。
画面左を見ると、17番染色体が選択されています。TP53は17番染色体上にある遺伝子です。
エクソンとイントロンを見てみよう
Genome Data Viewerでは、緑色の四角い部分がエクソン、その間をつないでいる細い線がイントロンとして表示されています。

実際のTP53を拡大して見てみましょう。

模式図ではエクソンとイントロンが同じくらいの大きさで描かれることもありますが、実際の遺伝子ではそれぞれの長さは大きく異なります。
TP53を見ても、小さな四角いエクソンの間に、長いイントロンが存在していることが分かります。
線の中にある矢印は、遺伝子の向きを示しています。TP53は基準となるゲノム配列に対してマイナス鎖側にある遺伝子であるため、この画面では矢印が左向きに表示されています。
プラス鎖・マイナス鎖について詳しく説明すると長くなるので、今回は「遺伝子には向きがあり、TP53はこの画面では左向きに並んでいる」くらいにしておきます。
TP53には複数のエクソンがあります。今回は、その中からエクソン6を例にして、エクソンの中には実際に何が書かれているのかを見てみましょう。
エクソンの中身を見てみよう
エクソン6をさらに拡大すると、A・T・G・Cからなる実際の塩基配列を見ることができます。
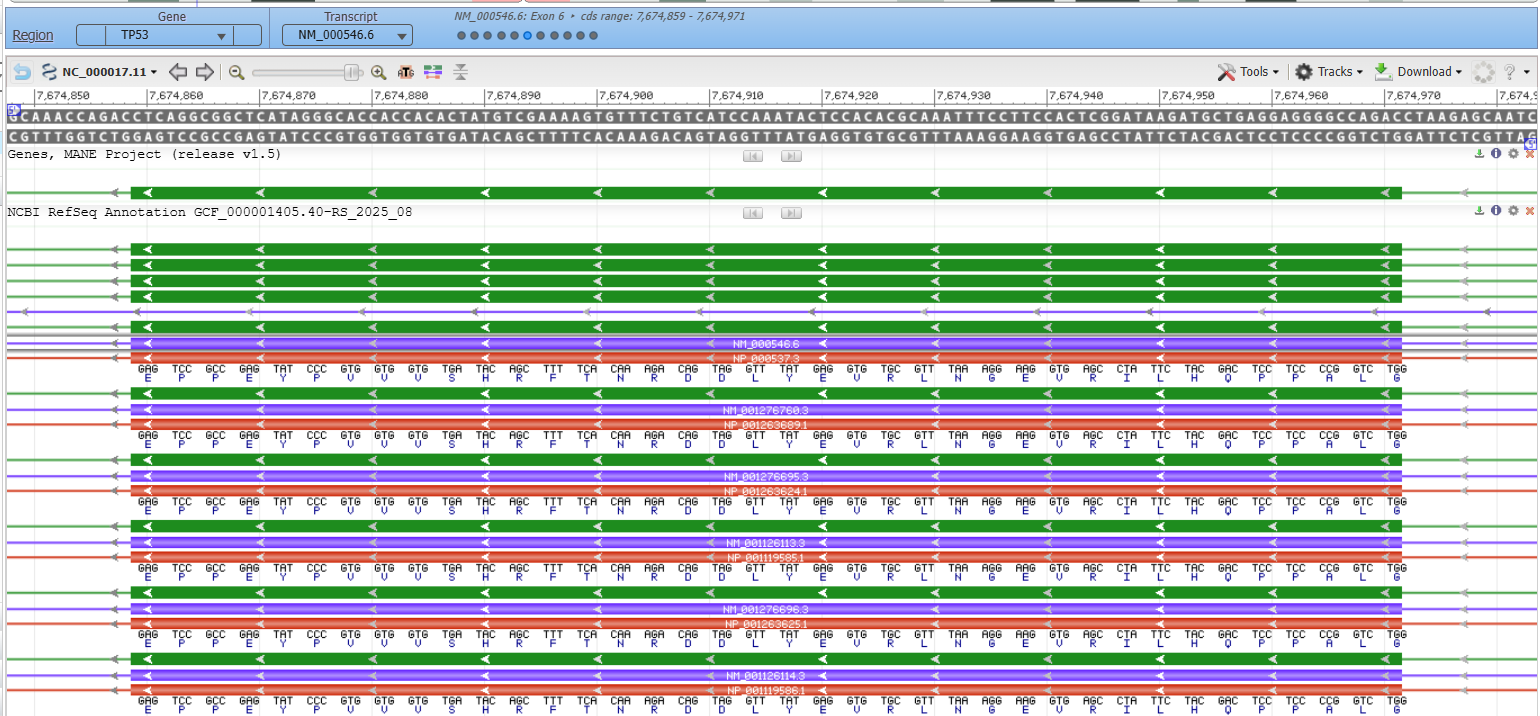
NM_000546.6を拡大してみると、塩基配列が3つずつ区切られ、その下に対応するアミノ酸が1文字で表示されています。

タンパク質に翻訳されるCDS(Coding Sequence)では、塩基配列を1塩基ずつバラバラに読むのではなく、3塩基を1組としてアミノ酸との対応を見ることができます。
mRNAでは、この3塩基1組をコドンと呼びます。
たとえば、
GAG|TCC|GCC|……
のように3塩基ずつ区切って読み、それぞれのコドンが基本的に1つのアミノ酸を指定します。
そのためGenome Data Viewerでは、塩基配列の下に、各コドンに対応するアミノ酸が1文字で表示されています。
ちなみに、アミノ酸の1文字表記は、必ずしもアミノ酸名の頭文字とは限りません。
例えば、Wはトリプトファン(Tryptophan)を表します。
そのため、アルファベットだけを見てアミノ酸名を推測することはできません。
エクソンとイントロンはその後どうなる?
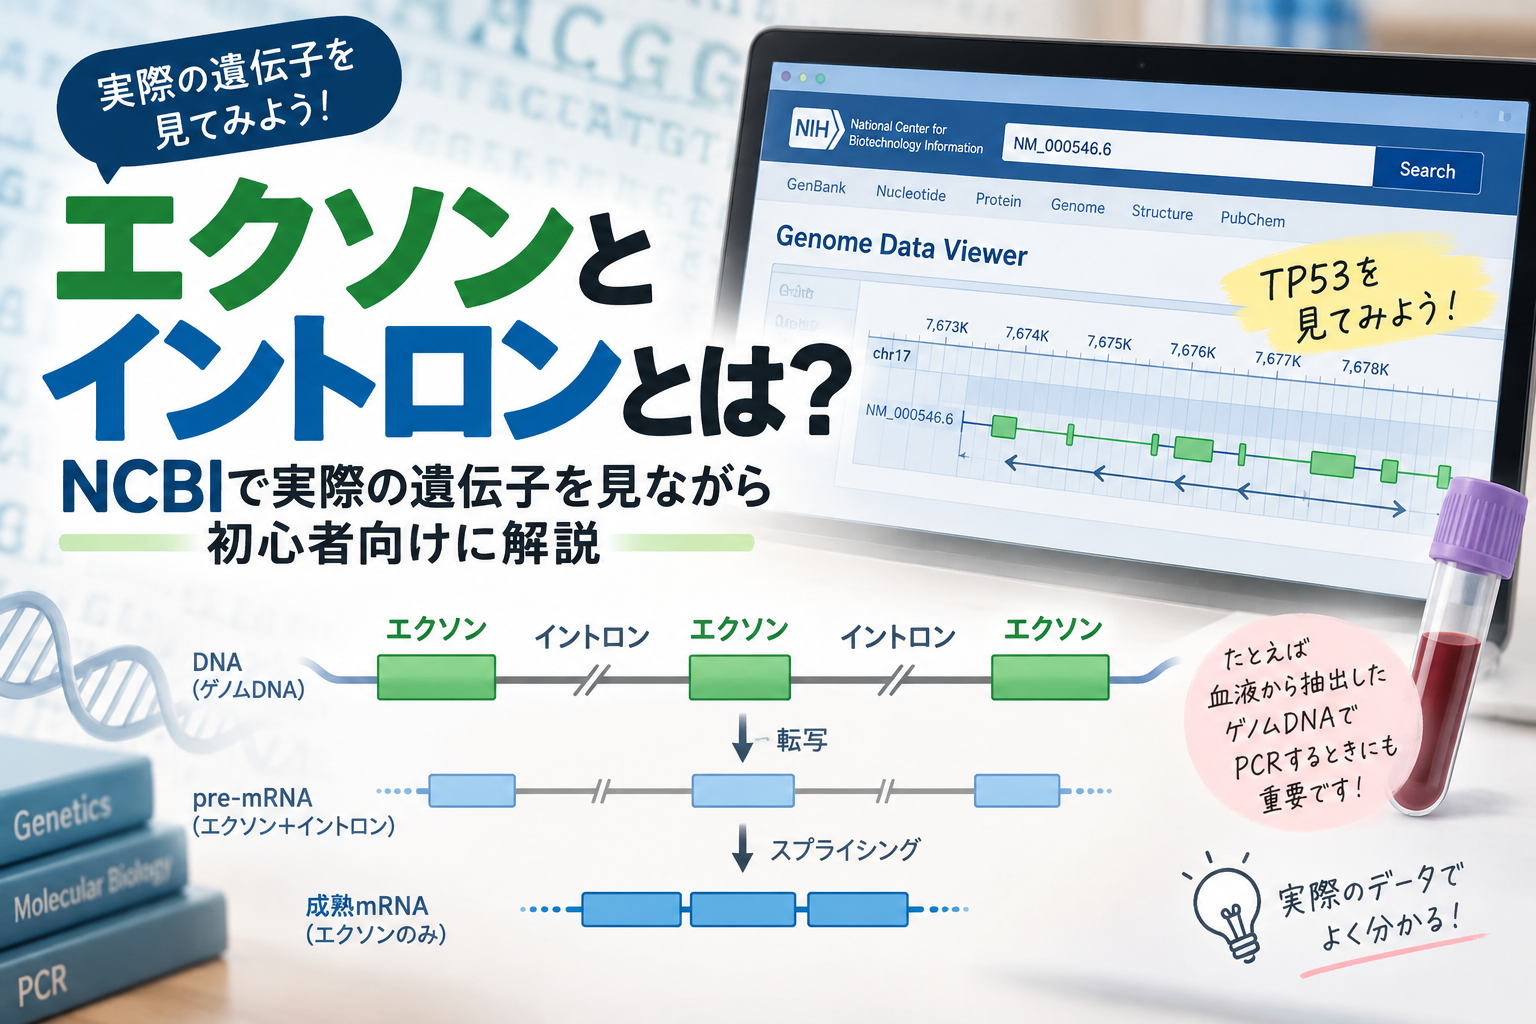
ここまでの内容を整理すると、遺伝子の構造を単純化すると次のようになります。
エクソン1 ― イントロン1 ― エクソン2 ― イントロン2 ― エクソン3
このように、遺伝子の中にはエクソンとイントロンが交互に存在しています。
そして、エクソンとイントロンには次のような違いがあります。
エクソン(exon)
エクソンはRNAへ転写されたあと、成熟したRNAに残る領域です。
イントロン(intron)
イントロンも最初はRNAへ転写されますが、その後、取り除かれる領域です。
つまり、DNAからRNAが作られた直後には、エクソンもイントロンも含まれています。
これをpre-mRNA(前駆体mRNA)といいます。
そこからイントロンを取り除き、エクソン同士をつなぎ合わせる過程をスプライシング(splicing)といいます。
スプライシングは「動画編集」のようなもの
エクソンとイントロンの関係は、動画編集をイメージすると分かりやすいかもしれません。
撮影したばかりの動画には、完成版で使う部分だけでなく、編集でカットする部分も含まれています。
DNAから転写されたばかりのpre-mRNA(前駆体mRNA)も同じです。
たとえば、DNAが
エクソン1|イントロン1|エクソン2|イントロン2|エクソン3
という構造だった場合、転写されたばかりのpre-mRNAにも、
エクソン1|イントロン1|エクソン2|イントロン2|エクソン3
と、エクソンとイントロンの両方が含まれています。
ここから、完成版では使わない部分をカットするようにイントロンが取り除かれ、エクソン同士がつなぎ合わされます。
エクソン1|エクソン2|エクソン3
このように、イントロンを取り除いてエクソン同士をつなぐ過程をスプライシング(splicing)といいます。
そして、編集が終わった「完成版」にあたるのが成熟mRNAです。
タンパク質をコードする遺伝子では、この成熟mRNAの情報をもとにタンパク質が作られます。
実際にどのくらい短くなる?
では、スプライシングによってイントロンが取り除かれると、実際の配列の長さはどのくらい変わるのでしょうか。
先ほどのTP53をもう一度見てみます。
Genome Data Viewerの画面を少しズームアウトして、NM_000546.6にカーソルを合わせると、次のような情報が表示されます。
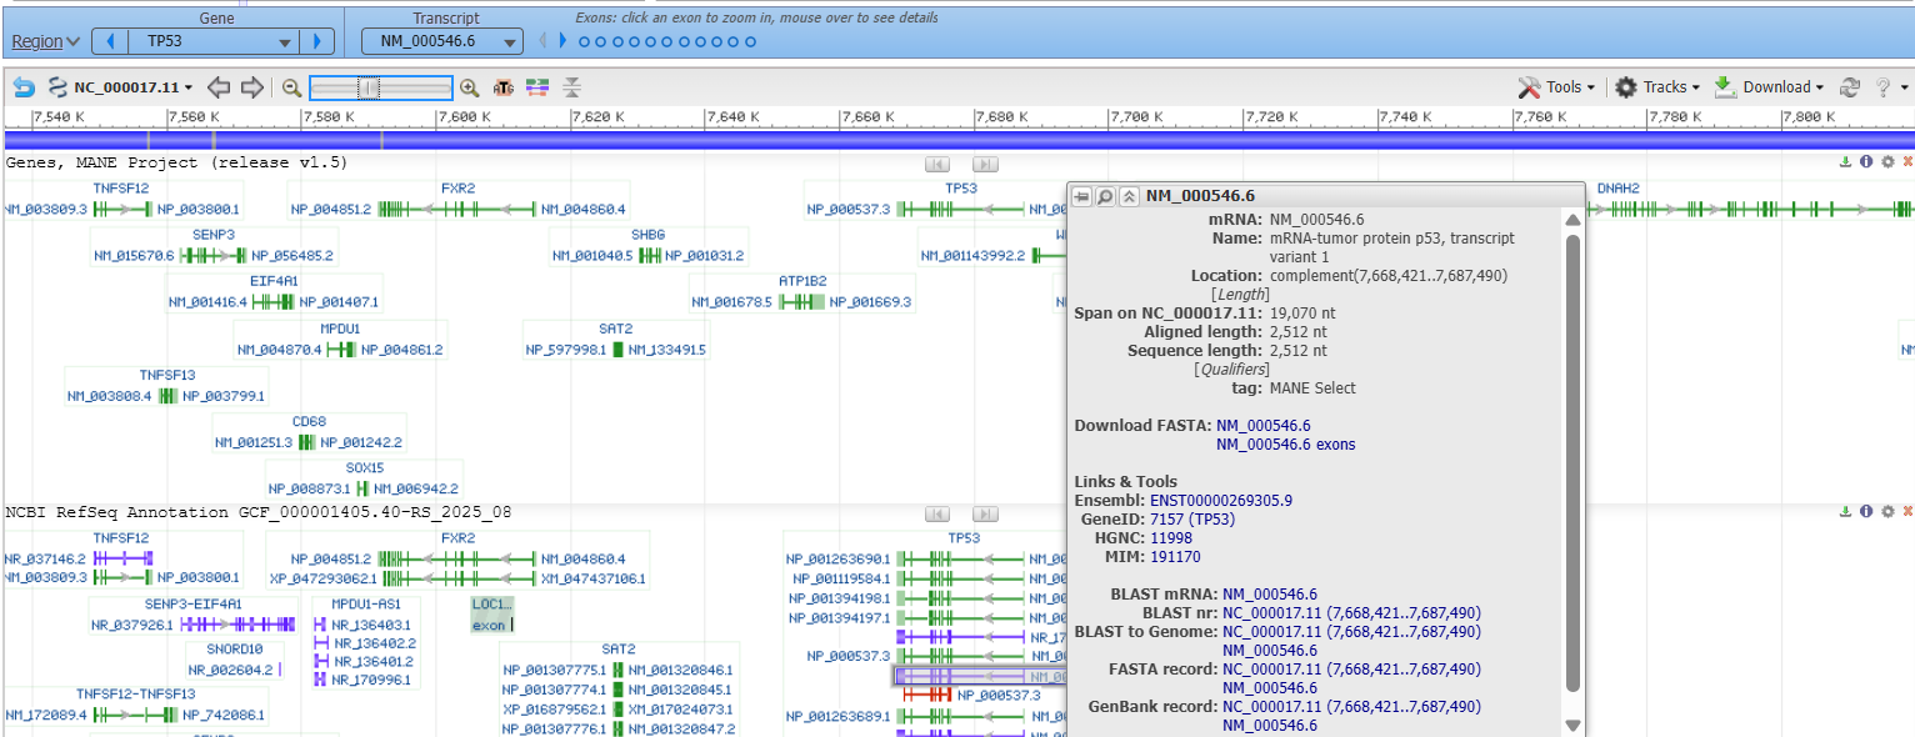
ここで注目したいのが、19,070 ntと2,512 ntという数字です。
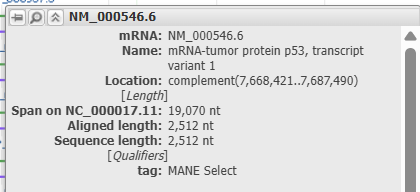
ntはnucleotide(ヌクレオチド)の略で、配列の長さを表すときに使われます。
- Span on NC_000017.11:19,070 nt
→ ゲノムDNA上で、この転写産物に対応する領域の端から端までの長さ。エクソンだけでなく、その間にあるイントロンをまたいだ範囲です。 - Sequence length:2,512 nt
→ スプライシング後のNM_000546.6のmRNA配列の長さです。
ゲノムDNA上では、エクソンとエクソンの間にイントロンが存在するため、端から端まで19,070 ntもの範囲があります。
一方、イントロンが取り除かれたNM_000546.6のmRNA配列は2,512 ntです。
実際の数字を比べてみても、イントロンを含むゲノム上の領域と、スプライシング後のmRNAでは長さが大きく異なることが分かります。
「エクソン=タンパク質を作る部分」ではない
ここまで読むと、「エクソンはタンパク質になる部分、イントロンは不要な部分」と思うかもしれません。
しかし、実際にはもう少し複雑です。
エクソンとは、正確にはスプライシング後の成熟RNAに残る領域です。エクソンの中には、実際にタンパク質のアミノ酸配列を決める領域だけでなく、タンパク質に翻訳されないUTR(非翻訳領域)が含まれることもあります。
この実際にタンパク質へ翻訳される領域をCDS(Coding Sequence)といいます。
つまり、エクソン=CDSではありません。
イントロンは「いらない部分」なの?
一方、スプライシングによって取り除かれるイントロンも、単なる「不要なDNA」とは限りません。
イントロンやその周辺には、遺伝子発現やスプライシングの調節に関わる配列などが存在することがあります。
この記事では詳しく扱いませんが、「成熟mRNAから取り除かれる=生物学的に意味がない」ではないことには注意が必要です。
なぜエクソンとイントロンの位置を調べるの?
では、なぜわざわざNCBIを使って、エクソンとイントロンの位置を確認する必要があるのでしょうか。
私が実際にエクソンを調べることになったきっかけの一つが、PCRのプライマー設計でした。
NCBIで表示されるmRNA配列では、イントロンはすでに取り除かれています。一方、血液などの検体から抽出したゲノムDNA(細胞がもともと持っているDNA)には、エクソンだけでなくイントロンも含まれています。
たとえば、調べたい変異がエクソンの中にあり、その周辺をゲノムDNAからPCRで増幅したいとします。
このとき、変異を含む適切な長さのDNAを増幅するためには、変異がエクソンのどこにあるのか、その前後にはどのような配列があるのかを確認する必要があります。
特に変異がエクソンの端に近い場合には、目的のエクソンを挟むように、隣接するイントロン領域にプライマーを設計することもあります。
つまり、mRNAの配列だけを見ていても、ゲノムDNAを鋳型としたPCRのプライマーを適切に設計できない場合があります。
そのため、ゲノムDNAとmRNAの違いを理解し、エクソンとイントロンがゲノム上のどこにあるのかを確認することが大切です。
まとめ
今回は、NCBI Genome Data Viewerで実際のTP53を見ながら、エクソンとイントロンについて確認しました。
エクソンとイントロンは、単に「必要な部分」と「不要な部分」に分かれているわけではありません。
エクソンはスプライシング後の成熟RNAに残る領域であり、イントロンは転写されたあと、スプライシングによって取り除かれる領域です。
また、エクソンのすべてがタンパク質に翻訳されるわけではなく、イントロンも単なる不要な配列とは限りません。
そしてPCRやプライマー設計では、目的とする領域がどのエクソンにあるのか、周囲のイントロンがどこにあるのかを確認する必要がある場合があります。
そのためには、ゲノムDNAとmRNAでは配列の構造が異なることを理解したうえで、目的に応じた配列を見ることが大切です。
実際の遺伝子をNCBIで見てみると、模式図だけでは分かりにくかったエクソンとイントロンの関係が、少し具体的に見えてきます。