ある遺伝子に変異が見つかったとき、
c.574C>T
のような変異表記を目にすることがあります。
これは、変異の位置と、どの塩基がどの塩基に置き換わったのかを表しています。
実際の検査や研究では、変異を含む領域をPCRで増幅し、その塩基配列を読むサンガーシークエンスが使われることがあります。
今回はその第一歩、
「変異はどこにあるのか?」
を、超有名な遺伝子 TP53 を例に、NCBIを使って調べてみます。
🧬 今日の問題
今回は、こんな情報を渡されたとします。
遺伝子:TP53
RefSeq:NM_000546.6
変異:c.574C>T
この変異は、実際のmRNA配列のどこにあるのでしょうか?
NCBIを使って調べてみます。
今回は最初からRefSeq(NM_000546.6)が指定されているため、どのmRNA配列を基準にするかは分かっています。
実際の仕事ではRefSeqが指定されていないこともあります。その場合は、まずどのtranscriptを基準にするのかを調べる必要があります。
まず「c.574C>T」って何?
検索を始める前に、変異の表記を確認しておきましょう。
c.574C>Tは、
c.:coding DNA reference sequenceを基準にした表記574:CDSの開始位置から数えて574番目C>T:C(シトシン)がT(チミン)に置き換わった
という意味です。
c.は、タンパク質をコードする転写産物を基準に塩基の位置を表すときに使う表記です。
タンパク質の翻訳が始まる開始コドンの最初の塩基を c.1 として、そこから c.2、c.3……と番号を数えていきます。
ここで重要なのが、
c.574は「mRNA配列の574番目」という意味ではない
ということです。
c.1になるのは、mRNAの中でタンパク質を作る領域(CDS)が始まる最初の塩基です。
そのため、c.574が実際のmRNA配列の何番目なのかを知るためには、
「このmRNAではCDSがどこから始まっているのか」
を最初に調べる必要があります。
NCBIでTP53のRefSeqを探す
今回はNCBIを使います。
なお、遺伝子解析では、RefSeqやtranscript、CDSなど、初めて見ると分かりにくい用語がたくさん出てきます。
今回はそれぞれの用語には深入りせず、まずは「変異情報から、実際の塩基配列上の位置を見つけるまでの流れ」を追っていきます。
それぞれの用語については、別の記事でひとつずつ解説していきます。
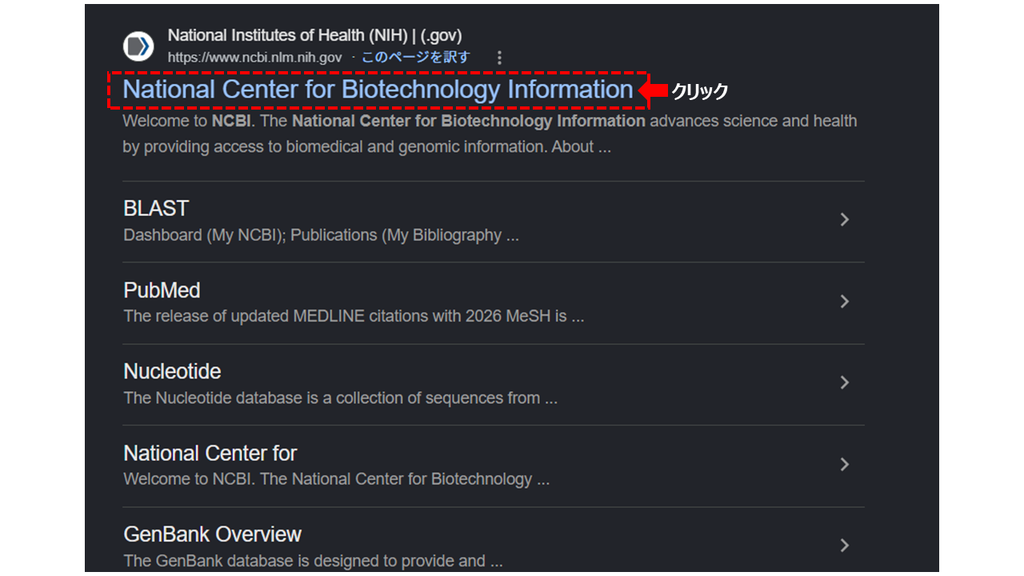
検索窓に、
NM_000546.6
と入力します。
すると、
Homo sapiens tumor protein p53 (TP53), transcript variant 1, mRNA
というRefSeqレコードが見つかります。
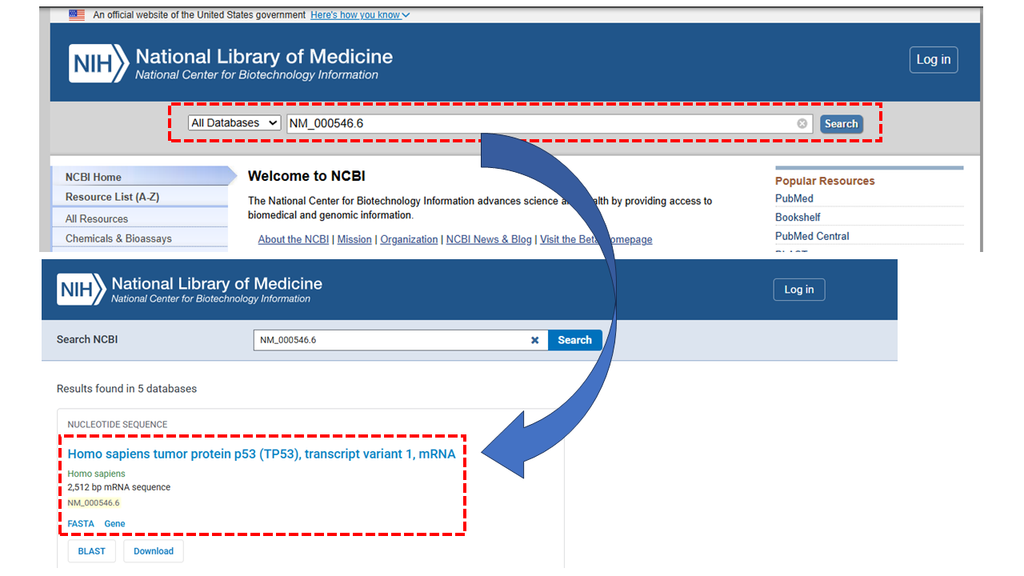
RefSeq(Reference Sequence)とは、NCBIが整理して提供している基準となる配列情報です。
今回の NM_000546.6 は、ヒトTP53の transcript variant 1のmRNA RefSeq を識別するためのアクセッション番号です。
簡単に言うと、「今回調べたいTP53のmRNA配列はこれ!」と指定するための番号です。
遺伝子には複数のtranscriptが存在することがあるため、変異の位置を調べるときは、どの配列を基準にしているのかを確認することが重要です。
今回は最初からNM_000546.6が指定されているので、このRefSeqレコードを開きます。
すると、下記のような配列情報が表示されます。
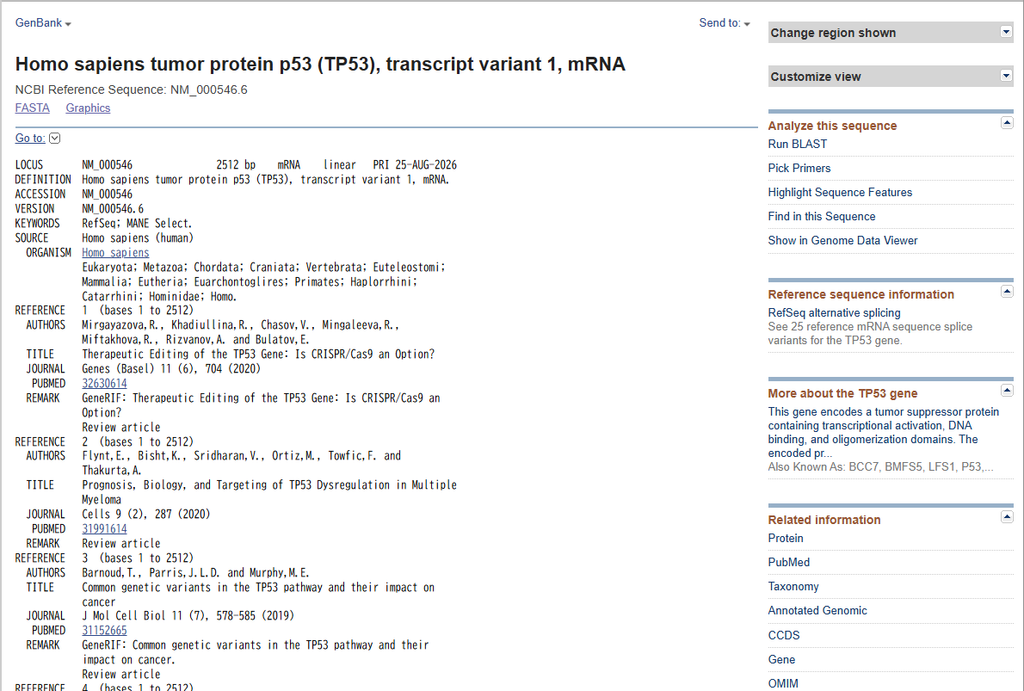
この中から、まずCDSがどこから始まっているのかを探していきます。
FEATURESからCDSを探す
NM_000546.6のレコードを開き、下へスクロールしていくと、
FEATURES Location/Qualifiers
という項目があります。
その中から、CDSを探します。
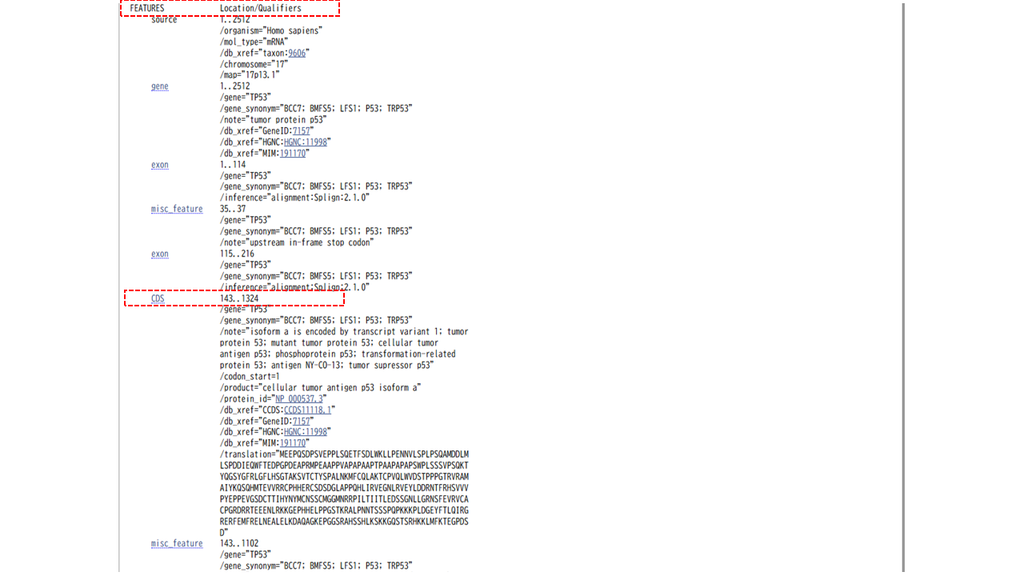
CDS(Coding Sequence)とは、mRNAの中でタンパク質を作るための情報をもつ領域です。
今回のNM_000546.6では、
CDS 143..1324
となっています。
これは、
NM_000546.6というmRNA配列の143番目から1324番目までがCDS
という意味です。
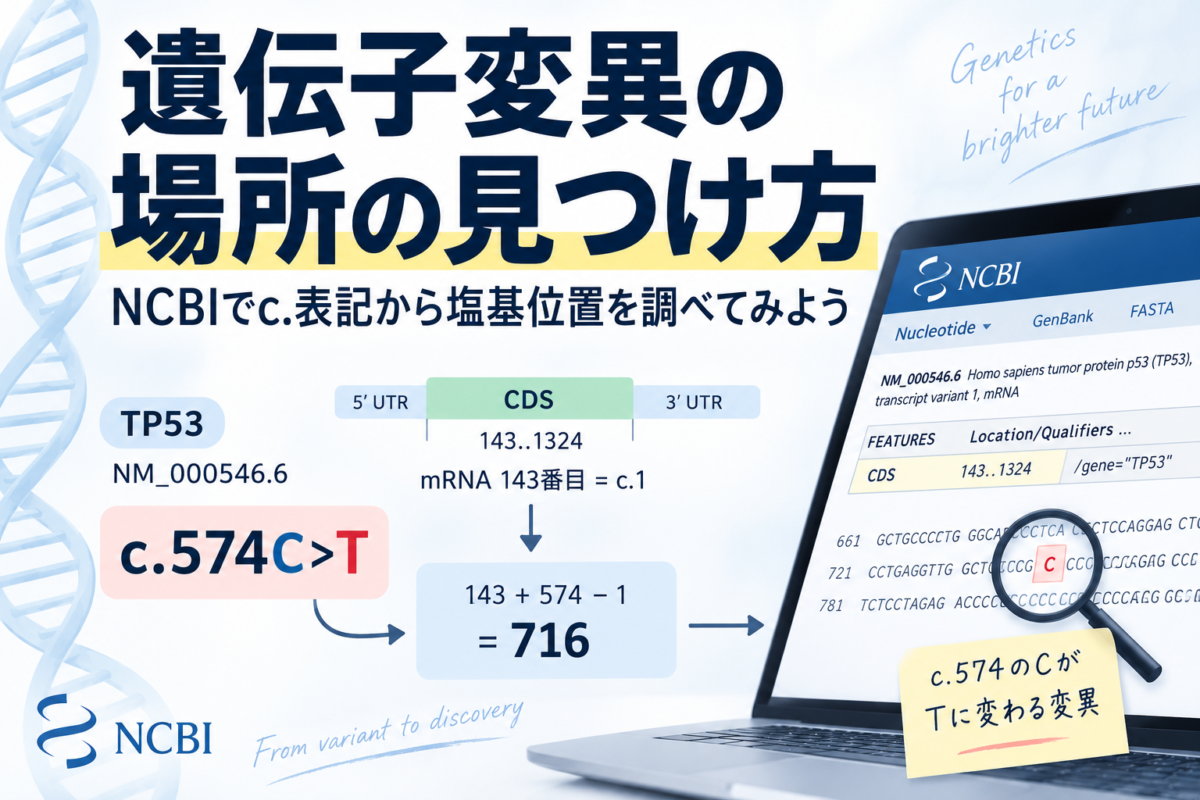
NM_000546.6ではCDSが143番目から始まっているため、mRNAの143番目 = c.1 となります。
ここが今回の計算のスタート地点です。
c.574はmRNA配列の何番目?
では最初の問題に戻ります。
今回調べたい変異は、
c.574C>T
です。
先ほど、mRNAの143番目 = c.1 だと分かりました。
そのため、
- mRNA 143番目 → c.1
- mRNA 144番目 → c.2
- mRNA 145番目 → c.3
- …
- mRNA 716番目 → c.574
となります。
計算すると、
143 + 574 − 1 = 716
です。
「−1」が入るのは、スタート地点であるmRNAの143番目を、すでに c.1 として数えているためです。
したがって、
NM_000546.6:c.574C>Tを調べるなら、mRNA配列の716番目を確認すればよい
ということになります。
ここで重要なのは、c.574は「mRNA配列の574番目」という意味ではないということです。
c.の番号はCDSの先頭を c.1 として数えるため、mRNAの先頭に5′ UTRなどがある場合、c.表記の番号とmRNA配列上の番号にはズレが生じます。
本当に716番目はCなのか確認してみる
では、実際の塩基配列を確認してみましょう。
NCBIの配列では、左側の数字がその行の最初の塩基の位置を表しています。
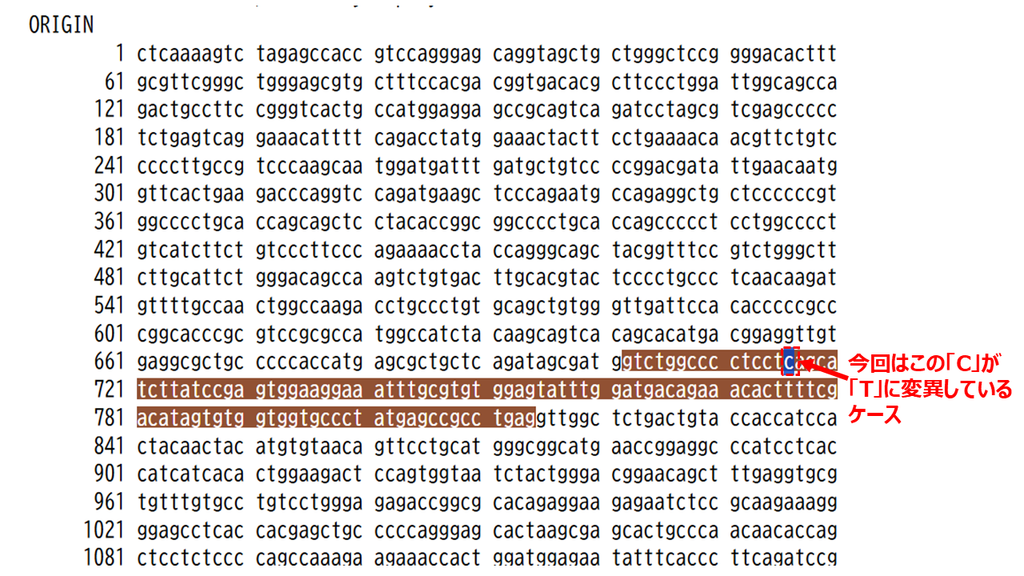
716番目は 661 から始まる行の中にあります。配列を数えていくと、716番目の塩基はCであることが確認できます。
今回の変異は、c.574C>Tなので、この716番目のCがTに置換している変異ということになります。
ClinVarにも変異情報が登録されている
NCBIには、ClinVarというデータベースがあります。
ClinVarは単なる「存在する変異の一覧」ではなく、ヒトの遺伝子変異と疾患との関連や臨床的な評価について、検査機関などから提出された情報を集めたNCBIのデータベースです。
今回の NM_000546.6:c.574C>T を検索すると、この変異がClinVarに登録されていることを確認できます。
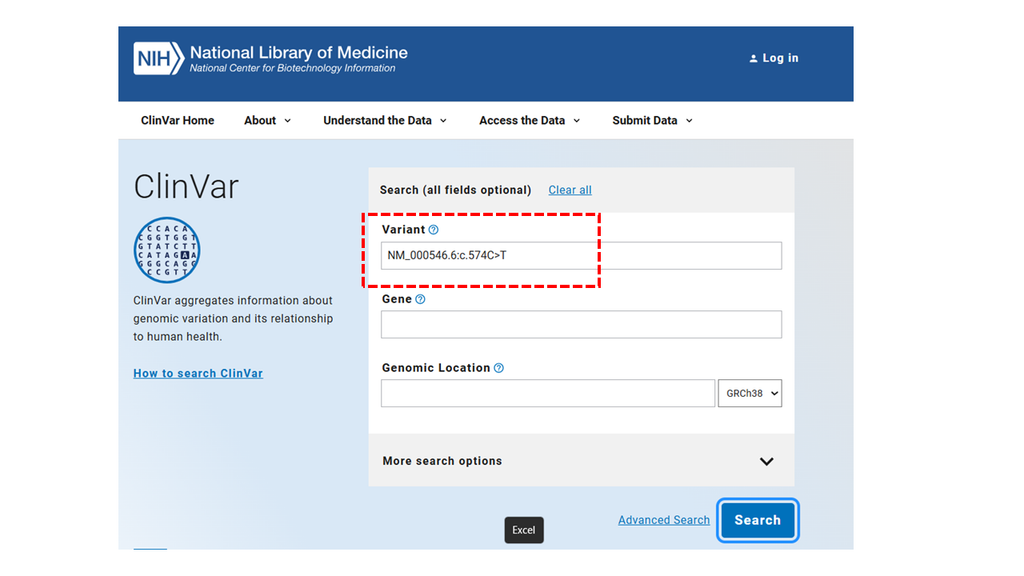
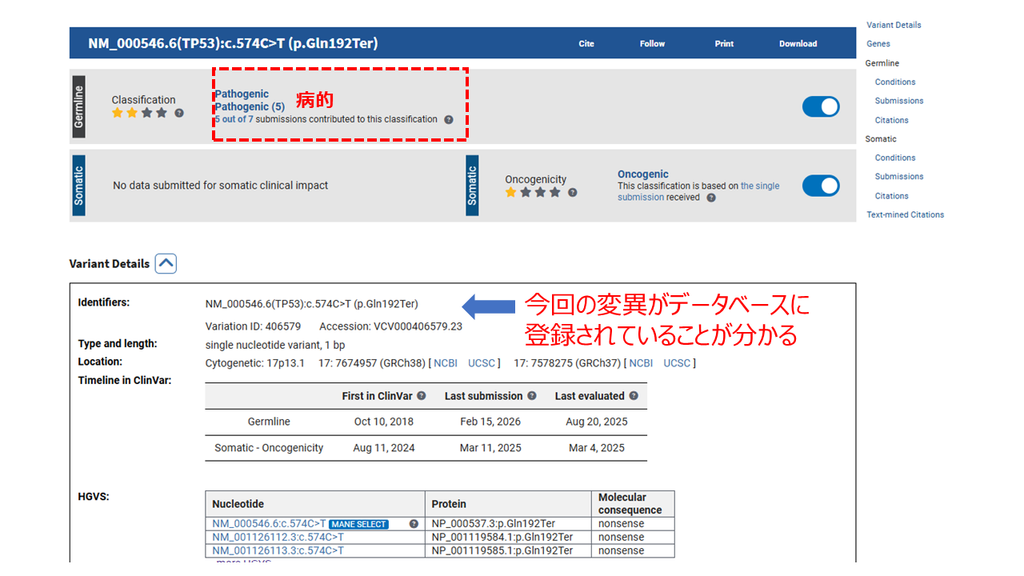
画面には Pathogenic(病的) など、この変異について提出された臨床的な評価も表示されています。
今回は変異の場所を調べることが目的なので、ClinVarの詳しい見方については別の記事で紹介します。
まとめ
今回は、c.574C>Tという変異が、実際のmRNA配列のどこにあるのかをNCBIを使って調べました。
流れを整理すると、
① RefSeqを確認する
TP53 → NM_000546.6
② NCBIでRefSeqレコードを開く
③ FEATURESからCDSを確認する
CDS 143..1324
④ c.1の位置を確認する
mRNA 143番目 = c.1
⑤ c.574をmRNA上の位置に変換する
143 + 574 − 1 = 716
⑥ 実際の配列を確認する
mRNA 716番目 = C
これで、c.574C>TのCが実際のmRNA配列のどこにあるのかを見つけることができました。
ポイントは、c.574=mRNAの574番目ではないことです。
c.の番号はCDSの先頭を c.1 として数えるため、まずCDSの開始位置を確認する必要があります。
※変異の位置は、基準とするRefSeq(transcript)によって表記が異なる場合があります。実際の解析では、どのRefSeqを基準にした変異なのかを確認することが重要です。
今回は変異の位置を見つけるところまででしたが、サンガーシークエンスを行うためには、さらに変異がどのexonにあるのか、周辺の配列はどうなっているのかを確認していきます。
この続きは、また別の記事で紹介します。